从来源记录、开放全文到一跳引用和本地 PDF 章节
Paper Search MCP
找到论文,也核对读到了什么
让 AI 助手调用论文检索与阅读工具,保留来源、标识符和实际取得的内容;先区分 MCP 服务与 Skill,再检查每一步的交付。
 打开作者原图
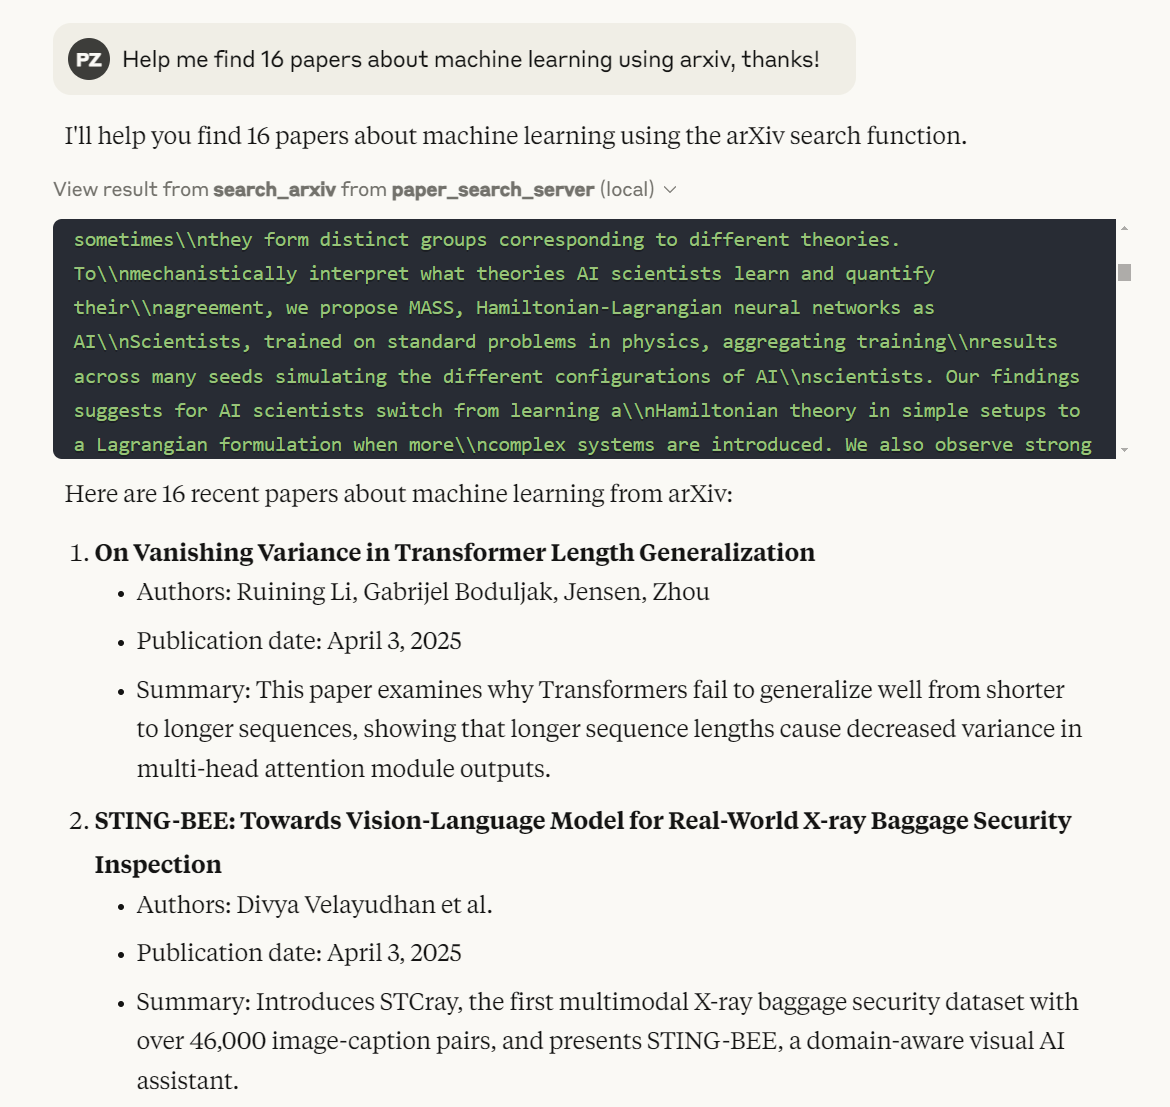
画面展示 search_arxiv 调用及标题、作者、日期、摘要;还需要继续核对记录和取得正文。
查看作者演示出处作者 README 的真实截图,展示一次工具调用与候选清单;不是本站运行结果,也不证明当前所有来源可用。截图中的论文信息未另行核验。MIT © 2025 OPENAGS。
实际接入方式
- 本地 stdio MCP 客户端
- Claude Code + CLI Skill
- 命令行
- DSH profile
- GitHub Star
- 2,950
- 版本
- 0.1.4
- 资料核对
适合把文献发现推进到可核对的阅读材料
从一个小问题和少量来源开始。先保存原始记录与失败,再选几篇核对身份、取得正文;让后续综述保留“读到了什么、还缺什么”。
选一个任务,开始使用
先在本地取得固定源码并查看工具,再把同一目录接入客户端。下面六个任务分别面向发现、核对、取文、扩展引用、章节定位和已有机构权限。
指定研究问题、来源与每源数量,得到可继续筛选的候选,而非声称覆盖全部文献。
取得本页核对的源码,并列出工具
在尚未存在 paper-search-mcp 子目录的位置运行。最后一行列出此源码实际注册的工具,不执行论文查询;首次 uv run 会安装依赖。代码固定到本页核对的提交,不能只用同为 0.1.4 的 PyPI 版本号替代。
查看作者安装说明git clone https://github.com/openags/paper-search-mcp.git cd paper-search-mcp git checkout cab1b5cc276a0cd004a0044003926a6440088049 mkdir -p downloads uv run -m paper_search_mcp.cli tool --list把同一源码目录接入 MCP 客户端
macOS 的 Claude Desktop 配置文件是 ~/Library/Application Support/Claude/claude_desktop_config.json;Windows 为 %APPDATA%\Claude\claude_desktop_config.json。把示例合并进其中的 mcpServers,保留已有服务;其他宿主使用自己的 MCP 配置入口。将两处 /absolute/path/to/... 换为实际源码路径,客户端找不到 uv 时改用该程序的绝对路径。保存并重启客户端,确认工具可见,再发送任务。下载目录同时是章节工具的读取根目录。
查看作者源码启动说明{ "mcpServers": { "paper-search-mcp": { "command": "uv", "args": [ "run", "--directory", "/absolute/path/to/paper-search-mcp", "-m", "paper_search_mcp.server" ], "env": { "PAPER_SEARCH_MCP_TRANSPORT": "stdio", "PAPER_SEARCH_MCP_SECTION_PDF_ROOT": "/absolute/path/to/paper-search-mcp/downloads" } } } }把这段话发给 AI
以下为本站编写的任务示例,不是运行结果。替换方括号中的材料后发给已接入工具的助手;表格与笔记由助手整理,服务本身返回记录、文字或文件路径。
请使用已接入的 Paper Search MCP,研究问题是:[一个具体问题]。关键词及同义词:[英文检索词];纳入范围:[年份、研究对象、文献类型];排除条件:[不需要的内容]。先确认能发现 search_papers 工具,再开始检索。 第一轮调用 search_papers(query="[检索词]", sources="arxiv,crossref,openalex", max_results_per_source=5)。这是每个来源最多 5 条;不要把 CLI 的 fast/fastest 当作 MCP 来源名,也不要声称 year 能过滤这三个来源。 保存实际调用参数和原始返回;检查 sources_used、source_results、errors,再按真实出版日期与摘要人工筛选。若日期是占位值、摘要缺失或来源报错,明确标记;空结果不能直接写成没有相关研究。需要严格日期范围时,改用带 filter 的专用 Crossref/OpenAlex 工具,并记录过滤条件。 请整理候选表:标题、作者、年份及日期精度、source、paper_id、DOI、原始链接、摘要可得性、纳入/排除/待核理由。检查同名记录、预印本与正式发表版,不把自动去重当作版本核验。最后给出本轮覆盖了哪些来源、哪些仍未查到;不要仅凭标题生成论文结论。
检查你拿到的结果
- 候选表与实际检索参数、每源返回数量及失败记录。
- 每条候选有 DOI 或来源 ID、原始链接及筛选理由;缺失信息保留待核。
- 核对年份、版本和检索覆盖;本轮结果不能代替系统综述的完整检索策略。
进一步了解这个 Skill
Paper Search MCP 把论文来源的检索、部分 PDF 下载与文字读取接到 AI 助手。它的主体是 Python 工具服务;仓库中的 paper-search Skill 则告诉 Claude Code 如何调用命令行,DSH 另有调用 MCP 的指令。选用时,先确定你的宿主怎样运行工具,再决定要查记录、取全文,还是沿引用关系继续找文献。
一次统一检索可以并行访问指定来源,并按 DOI 或标题与作者做基础去重。返回中保留每源数量和部分错误,便于追查漏项;但它没有统一所有数据库的查询语法,也不保证空结果意味着没有文献。统一 year 参数只作用于 Semantic Scholar,数量上限是每个来源的数量。严肃筛选仍要核对日期、文献类型和预印本/发表版。
“查到论文”与“读到全文”是不同结果。PubMed、Crossref 等入口常用于发现记录;下载要看具体连接器、开放版本和权限。回退下载会尝试开放仓库,但返回可能只是失败说明。引用记录存在、PDF 身份匹配和原文支持某个论断也分别需要检查;工具不会自动把这些步骤变成一份经过验证的文献综述。
当前源码还提供 OpenAlex 的一跳引用查询、已有 PDF 的章节文字提取,以及显式选择的 WoS/Scopus 接口。章节工具依赖可提取文字和 POSIX 环境;机构服务依赖已有凭据与实际授权。这些能力适合把候选文献推进到可核对的阅读材料,随后再交给综述或研究流程整理。
本页按 2026 年 10 月 2 日的固定源码提交编写。核查时 PyPI 仍显示 7 月上传的 0.1.4,而该源码也标为 0.1.4;同一版本号不能证明发布包包含后来新增工具。因此首次路径使用固定源码并先列出工具,已有安装则应核对实际工具清单。
来源与核验
资料核对
已核对固定提交的 README、两类 Skill、接入说明及相关检索、下载、引用和章节源码,并查看作者演示图;未安装或运行该服务,未执行学术检索、模型任务或验证生成质量。