Deep Research Skills
先定对象和字段,再逐批调查
Weizhena 的五个研究 Skill 把课题拆成可修改的对象清单与字段定义,按批次调查为 JSON,再单独整理成 Markdown 报告。适合需要统一比较维度、逐项补证据的选型或资料综述。
作者列出的使用环境
- Claude Code
- Codex
- OpenCode
- GitHub Star
- 2,441
- 资料核对
适合先把“查谁、查什么”定清楚的研究
当结果要按同一组字段逐项比较时,这套流程很有用:技术选型、论文清单、竞品资料都可以保留对象级数据,补字段后继续查。先确认一份小清单,再检查第一批 JSON,通常比一开始放大并行数量更容易发现研究范围的问题。
选一个任务,开始使用
以下三项按顺序衔接:先确认清单,再批准调查,最后生成报告。可以先只完成第一项;后两项需要前一阶段的实际文件。
第一次使用从三项候选开始,只完成大纲。下例是本站编写的调研任务,不包含对三种工具的预先评价。
安装完整目录与研究代理
选定一套语言后,完整复制五个 Skill、研究代理与模块,再准备 Python 依赖。下面给出固定提交的 Claude Code 中文路径;Codex 和 OpenCode 的配置差异见正文。
查看作者安装说明Claude Code 中文版:一次装齐再建工作区
先检查 ~/.claude/skills 中 research、research-add-items、research-add-fields、research-deep、research-report 及同名代理是否已有要保留的内容;复制会更新同名文件。以下命令固定到本页核验提交,使用独立 Python 环境,并在仓库旁创建 research-workspace。启动后检查五个入口和 web-search-agent 可用,再复制第一项任务。仅安装一套语言;英文版将 research-zh 换为 research-en。后续会话从此仓库激活 .venv,再进入研究工作区启动。
查看作者安装说明git clone https://github.com/Weizhena/Deep-Research-skills.git deep-research-skills cd deep-research-skills git checkout 6ce38f60e3f8b22502c29873f96503a4e0c5addb python3 -m venv .venv source .venv/bin/activate python -m pip install pyyaml mkdir -p ~/.claude/skills ~/.claude/agents cp -r skills/research-zh/* ~/.claude/skills/ cp agents/web-search-agent.md ~/.claude/agents/ cp -r agents/web-search-modules ~/.claude/agents/ mkdir -p ../research-workspace cd ../research-workspace claude把这段话发给 AI
示例采用 Claude Code 中文版入口。每次在研究工作区打开会话,使用实际文件路径;这些产物是预期交付,本页没有执行第三方研究任务。
/research 小团队浏览器回归测试选型 我已按本页安装中文版 Skill、web-search-agent 和模块,并在空白 research-workspace 中打开 Claude Code。先确认这五个 Skill、研究子代理、联网检索及可导入 yaml 的 Python 均可用;缺少任何一项就说明缺什么。 初始对象是 Playwright、Cypress、WebdriverIO。团队维护一个 Web 应用,想比较在现有 CI 中运行测试与排查失败的方式;这次不安装工具、不跑性能测试。先取得当前日期,调研范围为近 12 个月的资料,产品当前行为以检索日的官方文档为准。先展示对象和字段建议,新增候选须经我确认;把时间范围和用途写入对象说明或字段描述,让后续子代理也能读到。 请在 browser-testing/ 下生成 outline.yaml 与 fields.yaml。建议字段为 name、official_url、checked_on、core_license、ci_execution、debugging_artifacts、setup_requirements、sources。sources 要记录关键字段对应的原始链接、支持内容和访问日期;事实与推断分开。字段用 fields → 分类名 → 带 name、description、detail_level 的字典列表;本轮不写 required 标记,结果 JSON 使用扁平字段。 请确认 batch_size=2、items_per_agent=1,并将 execution.output_dir 写成 browser-testing/results 的绝对路径。展示完整路径、对象数量及字段,等我确认后停在大纲阶段。
检查你拿到的结果
- 得到 browser-testing/outline.yaml(对象与执行设置)和 fields.yaml(字段含义与详略),此时尚无逐对象调查结果。
- 逐项确认候选、时间范围、来源字段、两名并行代理和每代理一项;确认输出目录指向这个课题,字段 schema 符合校验器。
- 若想补候选或字段,先用 /research-add-items 或 /research-add-fields 修改并确认,再进入深查。
进一步了解这个 Skill
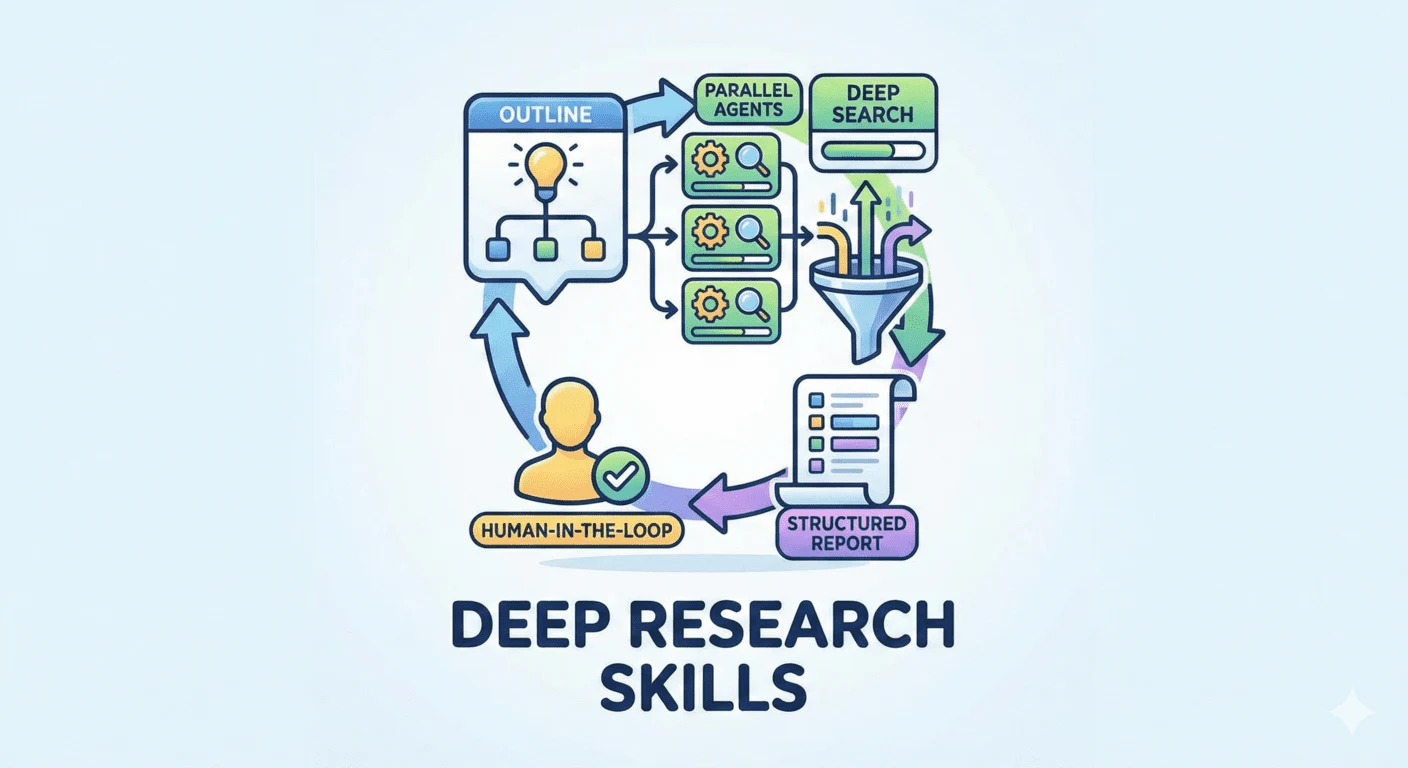
这组 Skill 把研究拆成五个分工明确的入口。/research 先用模型知识拟定对象与字段,再让研究代理联网补充;你确认后得到 outline.yaml 与 fields.yaml。前者记录查哪些对象、怎样分批,后者说明每个对象必须回答哪些问题以及回答到什么程度。
大纲可以继续修改:/research-add-items 增加对象,/research-add-fields 增加比较维度。确认后再调用 /research-deep,代理读取相同字段定义,按批次为各对象写 JSON,并运行字段覆盖校验。batch_size 是并行代理数,items_per_agent 是每个代理负责的对象数;规范要求进入下一批前取得同意,并描述了跳过已完成 JSON 的续查方式。
/research-report 是另一个明确步骤。它从已有结果生成 generate_report.py,再运行脚本输出带锚点目录与分组详情的 report.md。目录可以附带实际数据中的简短指标;正文会省略标为不确定的值,所以原始 JSON 和缺口说明同样值得保留。报告是资料整理的结果,不能直接充当产品测试或事实核验的证明。
作者提供 Claude Code/OpenCode 用的中英文目录与 Codex 专用目录。本页选 Claude Code 的完整安装作为首次使用路径,另外说明当前 Codex/OpenCode 配置需要检查的地方。它与 199-biotechnologies 的 Claude Deep Research 是不同项目:这里的中心是可编辑的对象—字段表,另一套则围绕证据台账、论断核对和多阶段长报告组织工作。
来源与核验
资料核对